Os Estados-membros aprovaram uma posição de negociação que clarifica as condições em que empresas tecnológicas poderão utilizar dados pessoais no desenvolvimento de sistemas de IA. A proposta prevê maior flexibilidade para o tratamento incidental de informações sensíveis, mas mantém salvaguardas e o direito dos cidadãos de se oporem à utilização dos seus dados. O processo legislativo ainda não está concluído.
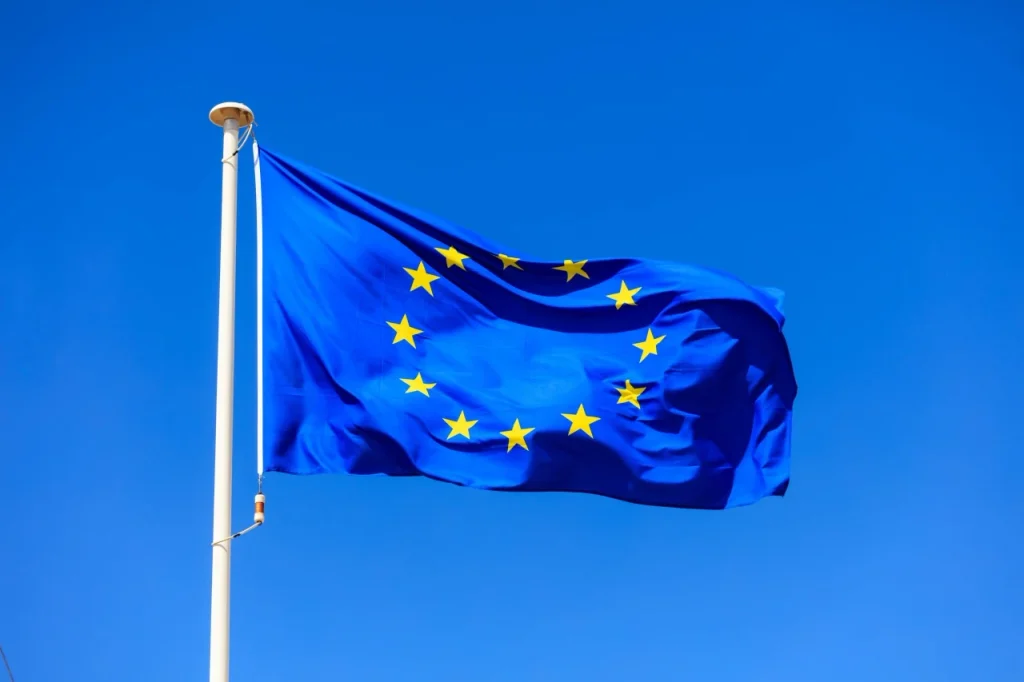
A União Europeia deu mais um passo na revisão das regras que regulam a protecção de dados pessoais, com o objectivo de reduzir os obstáculos administrativos ao desenvolvimento de tecnologias digitais, incluindo sistemas de inteligência artificial (IA). A iniciativa integra o pacote legislativo conhecido como Digital Omnibus, que pretende simplificar diferentes normas do espaço comunitário e facilitar a sua aplicação pelas empresas.
A 21 de Outubro de 2026, o Conselho da União Europeia aprovou a posição negocial dos Estados-membros sobre a proposta de simplificação das regras digitais. Entre as alterações previstas estão clarificações ao Regulamento Geral sobre a Protecção de Dados (RGPD), particularmente relevantes para as empresas que desenvolvem modelos de inteligência artificial e necessitam de grandes volumes de informação para os treinar e testar.
A iniciativa procura conciliar dois objectivos: permitir que as empresas europeias desenvolvam tecnologias competitivas e preservar os direitos fundamentais dos cidadãos. A discussão centra-se na forma como os dados pessoais podem ser utilizados, nas condições em que determinadas informações sensíveis podem ser tratadas e nos mecanismos que devem impedir abusos.
Apesar do avanço, as alterações ao RGPD ainda não constituem um novo regime legal definitivo. A posição do Conselho servirá de base às negociações com o Parlamento Europeu, que terá de definir a sua própria posição antes de avançar para a fase seguinte do processo legislativo.
Interesse legítimo ganha relevância no treino de modelos de IA
Uma das áreas centrais da proposta é a clarificação do recurso ao chamado «interesse legítimo» como fundamento jurídico para o tratamento de dados pessoais no desenvolvimento de sistemas de inteligência artificial.
O RGPD já prevê o interesse legítimo como uma das bases legais que podem justificar o tratamento de dados, desde que sejam cumpridas as condições estabelecidas na legislação. A proposta procura esclarecer a sua aplicação a actividades como o treino, os testes e a validação de modelos de IA.
Na prática, esta clarificação poderá ajudar as empresas a determinar em que circunstâncias podem utilizar dados pessoais para desenvolver sistemas capazes de produzir textos, imagens, vídeos ou outras respostas automatizadas, sem depender necessariamente do consentimento individual para cada operação.
A possibilidade de recorrer ao interesse legítimo não significa, contudo, que qualquer conjunto de dados possa ser recolhido e utilizado livremente. A avaliação deve considerar as circunstâncias concretas do tratamento, a finalidade da utilização e os direitos e interesses das pessoas envolvidas.
A proposta mantém salvaguardas para impedir que esta base jurídica seja utilizada indiscriminadamente. A sua aplicação não poderá servir para contornar situações em que a legislação exige consentimento explícito ou para justificar tratamentos incompatíveis com os direitos dos titulares dos dados, incluindo as protecções aplicáveis aos menores.
Esta distinção é importante porque os sistemas de IA podem ser treinados com informação proveniente de diferentes contextos. A existência de dados disponíveis não significa, por si só, que a sua utilização para desenvolver um modelo seja legal.
Excepção prevê tratamento incidental de dados sensíveis
Outro ponto relevante diz respeito às categorias especiais de dados pessoais, que incluem informações sobre saúde, origem racial ou étnica, opiniões políticas, convicções religiosas e outros elementos particularmente sensíveis.
A proposta prevê uma excepção para o tratamento incidental e residual destas informações durante o desenvolvimento e o funcionamento de sistemas de inteligência artificial. O objectivo é responder a uma dificuldade prática: grandes conjuntos de dados podem conter informações sensíveis que não constituem o objectivo principal da recolha, mas que acabam por surgir no material utilizado para treinar os modelos.
Para beneficiar desta flexibilidade, as empresas terão de adoptar medidas de prevenção, incluindo filtros e mecanismos destinados a identificar e excluir dados sensíveis logo na fase de selecção das fontes de informação.
Se essas medidas não impedirem a entrada de dados protegidos nos conjuntos de treino, a proposta estabelece que as informações abrangidas devem ser eliminadas sem demora, quando tal seja possível.
A excepção não representa, portanto, uma autorização geral para recolher dados de saúde, opiniões políticas ou outras informações sensíveis com o propósito de alimentar sistemas de IA. O seu âmbito está associado à presença incidental dessas informações e às condições específicas previstas no enquadramento legal.
A intenção é reduzir as dificuldades técnicas enfrentadas pelas empresas sem eliminar a obrigação de proteger informações cuja utilização indevida pode causar prejuízos significativos às pessoas.
O que acontece quando os dados já estão incorporados no modelo?
A remoção de informação torna-se mais complexa quando os dados já foram utilizados no treino de um modelo de inteligência artificial. Ao contrário de uma base de dados convencional, em que um registo pode ser localizado e apagado, a informação aprendida por um modelo pode influenciar os seus parâmetros internos.
A proposta procura contemplar situações em que a eliminação directa deixa de ser tecnicamente viável, nomeadamente quando dados sensíveis ficam incorporados nos parâmetros do sistema e a sua remoção exigiria repetir integralmente o processo de treino.
Nesses casos excepcionais, as empresas terão de adoptar medidas para bloquear a informação em causa. As salvaguardas previstas procuram impedir que os dados continuem a ser divulgados, utilizados por terceiros ou explorados para produzir inferências sobre as pessoas a quem dizem respeito.
Este aspecto evidencia um dos desafios jurídicos e técnicos associados à inteligência artificial: garantir a protecção dos dados não apenas durante a recolha, mas também depois de estes terem sido utilizados para desenvolver um sistema.
A eficácia destas medidas dependerá da capacidade das empresas para identificar os riscos, controlar as respostas dos modelos e demonstrar que as informações protegidas não continuam a ser utilizadas de forma incompatível com as obrigações legais.
Cidadãos mantêm o direito de oposição
A flexibilização proposta é acompanhada por mecanismos destinados a preservar os direitos dos titulares dos dados. Entre eles está o direito de os cidadãos se oporem à utilização das suas informações pessoais no treino de sistemas de inteligência artificial.
Este direito é particularmente importante num contexto em que os dados podem ser utilizados para desenvolver modelos com aplicações muito diferentes da finalidade para a qual a informação foi originalmente disponibilizada.
A proposta procura dar maior clareza às condições em que as empresas podem tratar dados, sem retirar aos cidadãos a possibilidade de contestar utilizações que afectem os seus direitos.
O debate também envolve a pseudonimização, uma técnica que substitui identificadores directos por códigos ou outros elementos, dificultando a associação imediata de uma informação a uma pessoa concreta.
O Conselho pretende clarificar a aplicação das regras nesta matéria, mantendo a definição actual de dados pessoais. A análise deverá considerar se a identificação de uma pessoa continua a ser razoavelmente possível, tendo em conta os meios disponíveis e as circunstâncias concretas.
A pseudonimização pode reduzir riscos, mas não equivale automaticamente à anonimização. Se continuar a ser possível identificar uma pessoa através de informação adicional ou de outros meios razoáveis, os dados podem continuar abrangidos pelo RGPD.
Empresas procuram reduzir custos e incerteza jurídica
Para as empresas tecnológicas, a simplificação das regras poderá reduzir custos de conformidade e facilitar o planeamento de projectos de investigação e desenvolvimento. O treino de modelos de IA pode exigir a análise de enormes quantidades de informação, tornando a identificação das bases legais e dos procedimentos de protecção de dados uma tarefa complexa.
As alterações pretendem oferecer maior previsibilidade jurídica às organizações, especialmente quando desenvolvem sistemas que precisam de ser testados e aperfeiçoados continuamente.
As pequenas e médias empresas poderão beneficiar de procedimentos mais claros e de uma redução de encargos administrativos, desde que as novas regras sejam adoptadas nos termos previstos. A iniciativa faz parte de um esforço mais amplo da União Europeia para simplificar a legislação digital e melhorar as condições de competitividade das empresas europeias.
Contudo, a redução da burocracia não elimina a necessidade de avaliar os riscos de cada operação. As empresas continuarão a ter de respeitar as regras aplicáveis, implementar medidas de segurança e justificar o tratamento de dados pessoais.
A questão central será encontrar um equilíbrio entre a velocidade de desenvolvimento tecnológico e a protecção efectiva dos cidadãos, evitando que a simplificação seja interpretada como uma dispensa geral das responsabilidades legais.
Pacote digital vai além da inteligência artificial
O Digital Omnibus não se limita às alterações relacionadas com o treino de modelos de IA. O pacote inclui medidas para simplificar e reorganizar diferentes componentes da legislação digital europeia, abrangendo a protecção de dados, as regras de privacidade online, a reutilização de dados e a comunicação de incidentes de cibersegurança.
No domínio dos cookies e de outras tecnologias de rastreamento, o Conselho apoia a clarificação de situações específicas em que o consentimento poderá não ser necessário, como determinados procedimentos indispensáveis à prestação de um serviço, à medição de audiências ou à segurança dos dispositivos.
A proposta contempla igualmente alterações aos procedimentos de notificação de violações de dados pessoais, incluindo o alargamento de determinados prazos e a harmonização de requisitos para as organizações.
Outra vertente consiste em simplificar as regras relativas à reutilização de dados e reforçar determinadas protecções dos segredos comerciais. O objectivo é reduzir a fragmentação regulatória e tornar mais previsível a aplicação das normas em diferentes áreas da economia digital.
Estas alterações fazem parte de uma estratégia que procura diminuir a complexidade administrativa sem abandonar os objectivos gerais de protecção da privacidade, segurança e direitos fundamentais.
Processo legislativo ainda precisa de avançar
A aprovação da posição do Conselho da União Europeia representa um avanço nas negociações, mas não significa que todas as alterações propostas ao RGPD já estejam em vigor.
O Parlamento Europeu terá de estabelecer a sua posição de negociação. Depois disso, as instituições poderão iniciar as negociações interinstitucionais destinadas a alcançar um texto comum.
O conteúdo final poderá sofrer alterações durante esse processo, pelo que as empresas e os cidadãos ainda não devem tratar todas as disposições propostas como obrigações definitivas.
A discussão reflecte um dilema cada vez mais relevante para a economia digital europeia: como permitir que as empresas desenvolvam sistemas de inteligência artificial capazes de competir internacionalmente, sem comprometer a confiança dos cidadãos na utilização das suas informações pessoais.
Se for aprovada, a reforma poderá alterar a forma como as empresas interpretam algumas obrigações de protecção de dados durante o desenvolvimento de modelos de IA. O alcance concreto dessas mudanças dependerá, contudo, da redacção final da legislação e das salvaguardas que forem mantidas.
Por agora, a União Europeia avança com uma proposta de simplificação que procura facilitar a inovação tecnológica, mantendo o princípio de que a utilização de dados pessoais deve continuar sujeita a limites legais e à protecção dos direitos dos cidadãos.